文章 · 地震 AI
AI 為什麼經常漏判 S 波?
地震儀全天候記錄資料,台灣一年約記錄上萬次震動。從這些波形中辨識哪些是地震、發生於何時, 傳統上仰賴分析人員逐一檢視波形圖並標記。資深分析人員能夠標記得相當準確,但資料量龐大,人力終究有限。
因此近年來,地震學家將這項工作交由深度學習處理。模型訓練完成後,輸入一段波形, 便能輸出 P 波與 S 波各自的到達時刻。
P 波與 S 波是地震波的兩種類型。P 波傳播速度較快,最先抵達;S 波速度較慢、較晚抵達,但破壞力更強, 建築物最明顯的搖晃主要來自 S 波。判斷震源位置與地震規模時,兩者的到達時間都不可遺漏。
一種難以解釋的失敗模式
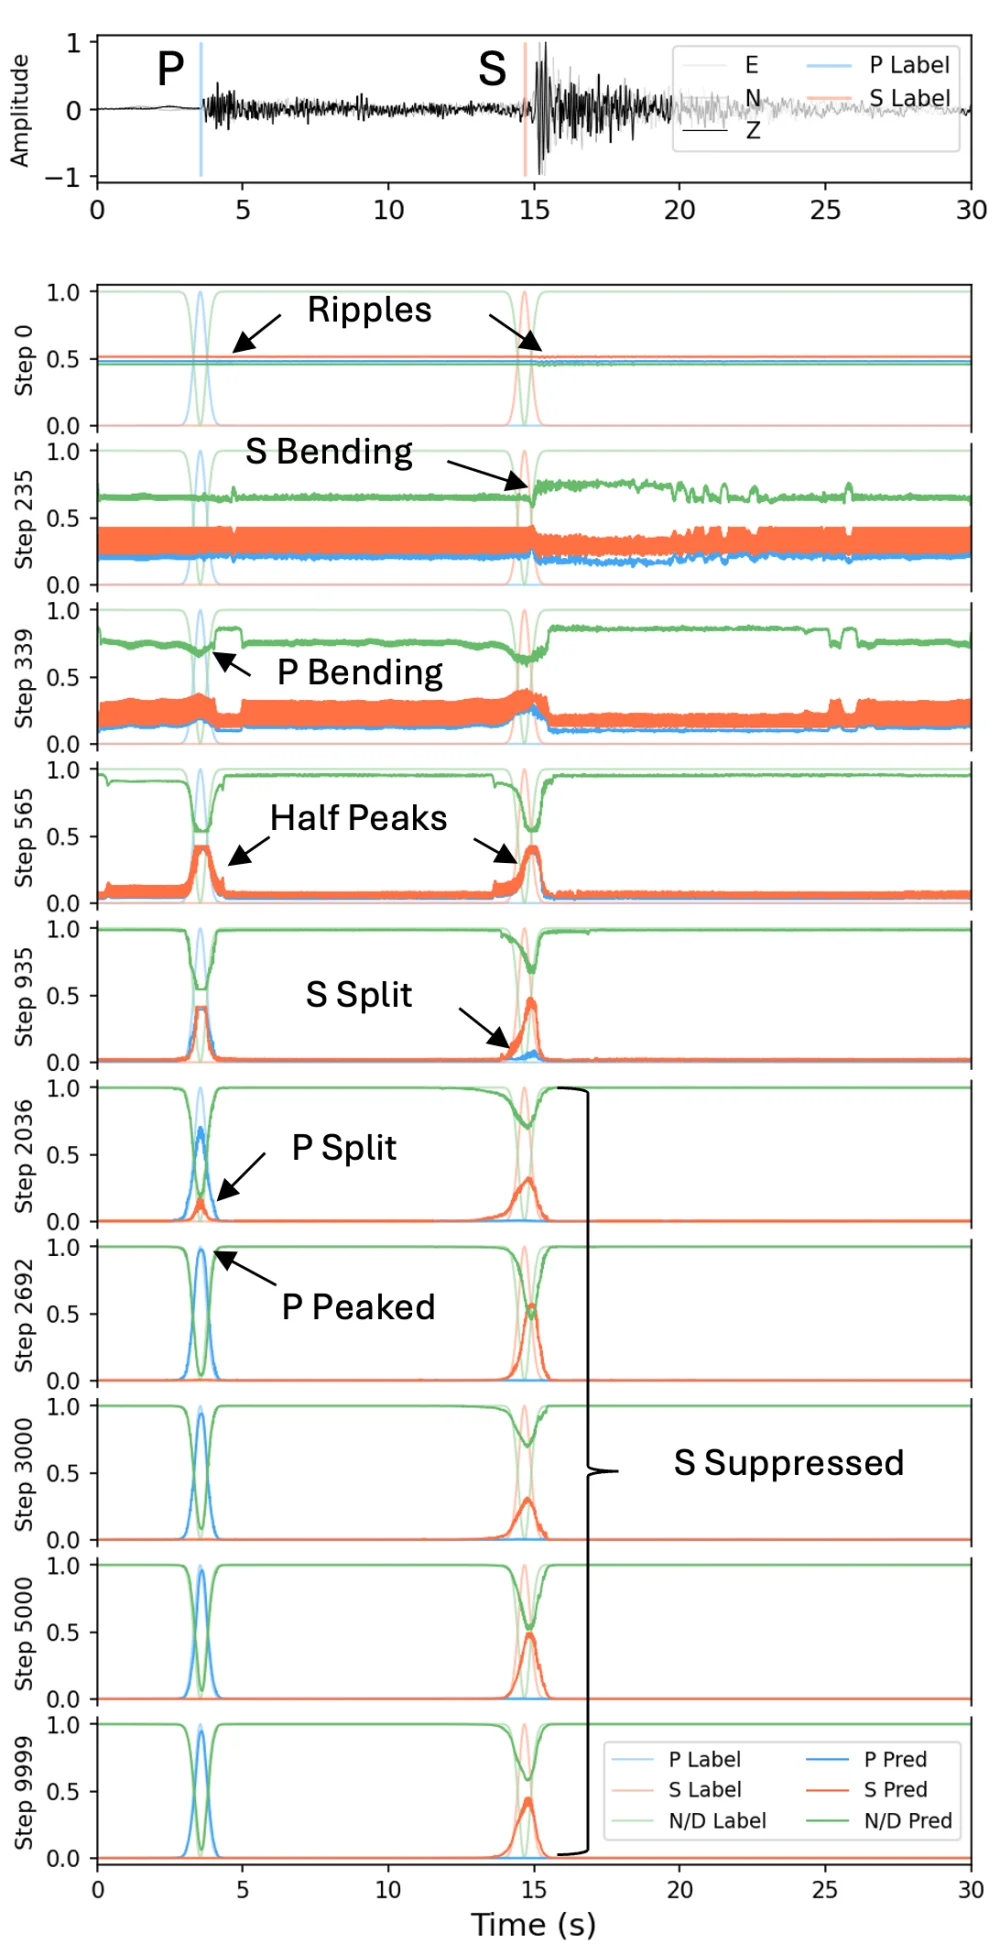
問題在於,AI 挑選 P 波時表現相當穩定,挑選 S 波時卻經常出錯。 在同一段波形中,S 波的位置對分析人員而言一目瞭然,模型卻輸出一個形狀扭曲、高度不足的小峰值, 恰好低於設定的偵測門檻,因而被視為未偵測到。
更特別的是,模型判斷的位置往往是正確的,時間沒有偏差,只是高度不足。
地震學界注意到這個現象已有多年,常見的因應方式是換用更大的模型、加入更多資料或調整訓練方法, 將其視為一項惱人的副作用,設法迴避。
這篇論文並未選擇迴避,而是著手釐清問題的根本原因。
預測停滯的原因
以評判一幅肖像畫是否相似為例,直覺的做法是觀察整張臉。 但若規則改為不可觀察整體,只能將畫面切成數百個小格,每格獨立評分後加總,評判便會遇到困難。
每一格只能指出該格應調亮或調暗,沒有任何一格能指出整張臉應向左移動。 因此當預測的形狀正確、位置卻稍微偏右時,每一格收到的訊號只有此處應調亮或此處應壓低。 預測於是越來越淡,位置卻始終無法修正。
傳統訓練 AI 挑選 S 波的方式,正是這種逐格評分。它沒有任何機制告訴模型整體應往哪個方向移動, 只能上下調整數值,S 波預測因此停滯在某個位置,並且越壓越扁。
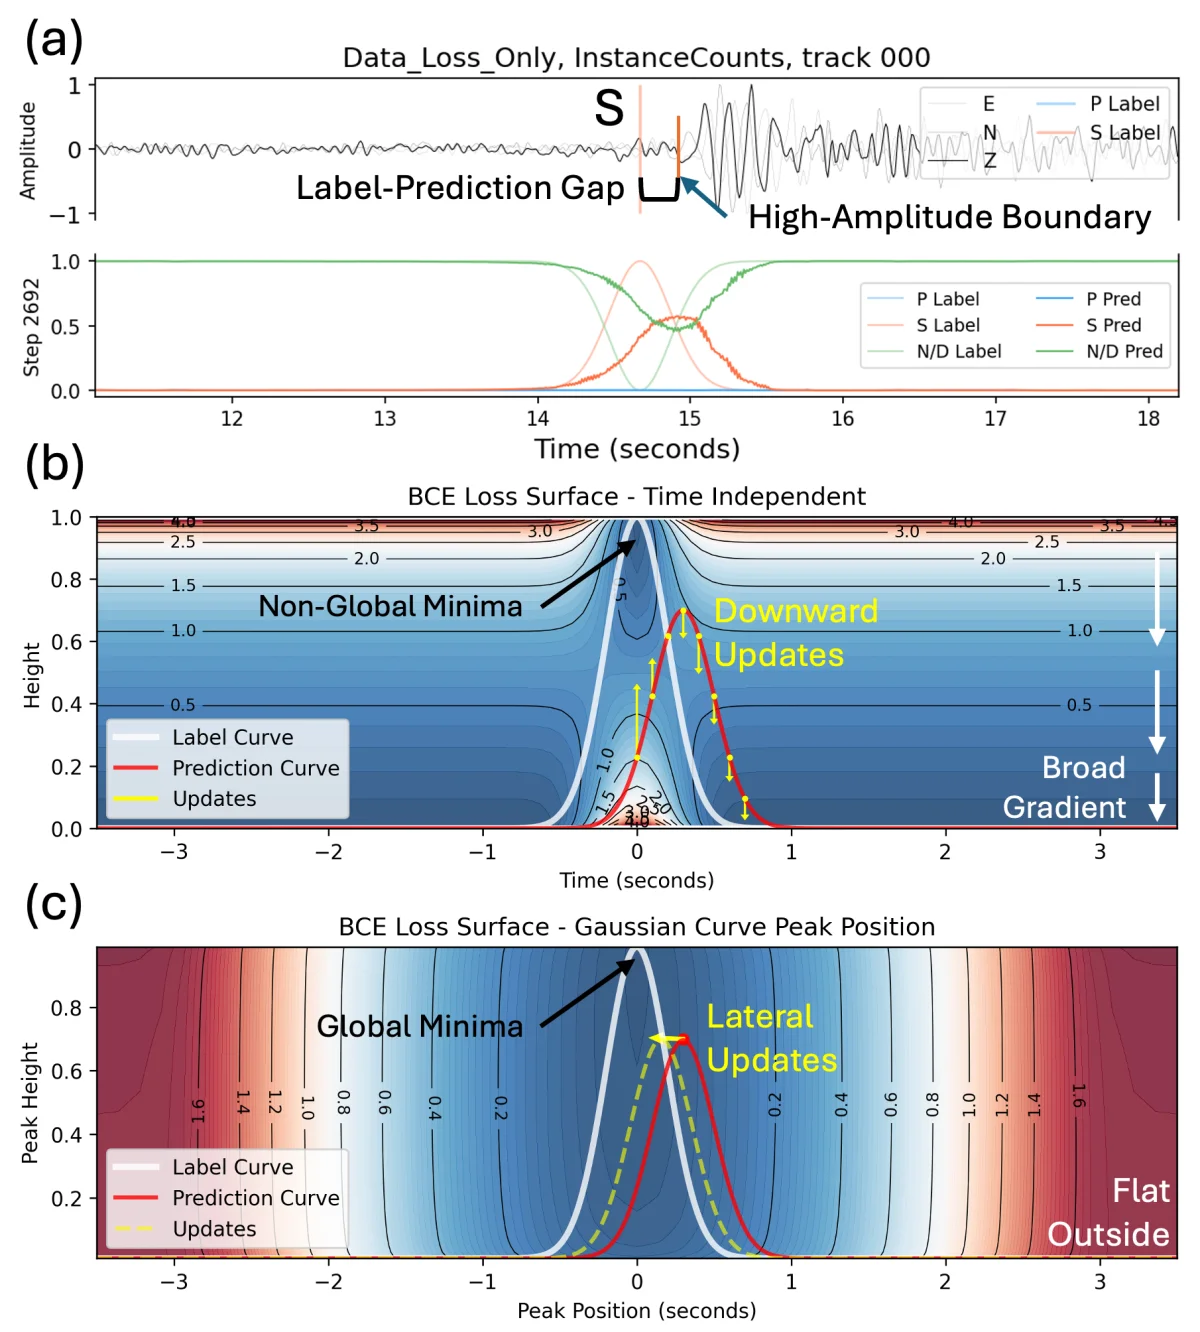
S 波特別容易出現這個問題,還有兩個加劇的因素。第一,S 波的標準答案本身較為模糊。 S 波傳播較遠之後,波形會變寬、邊界變得不清楚,即使是專家標記的位置也可能相差數百毫秒, 訓練資料中的正確答案因此帶有雜訊。第二,AI 模型傾向回應尖銳的特徵,會將預測固定在波形上最明顯的轉折處, 而這個位置恰好不是 S 波應在的位置。
上述三項因素同時作用,使 S 波預測停滯在無法改善的狀態。
解決方法
找出成因之後,便能據此提出解決方法。
作者採用一種稱為 GAN 的技術。GAN 通常用於生成影像或影片,原理是讓兩個模型互相對抗, 一個負責生成,一個負責鑑別。生成器設法騙過鑑別器,鑑別器設法分辨真假, 最終生成器的產出會越來越接近真實資料。
在這篇論文中,鑑別器的工作是檢視模型的輸出,判斷其整體形狀是否與真實標籤相似。 鑑別器評估的是輸出的整體形狀,不針對每一格的數值個別評分。
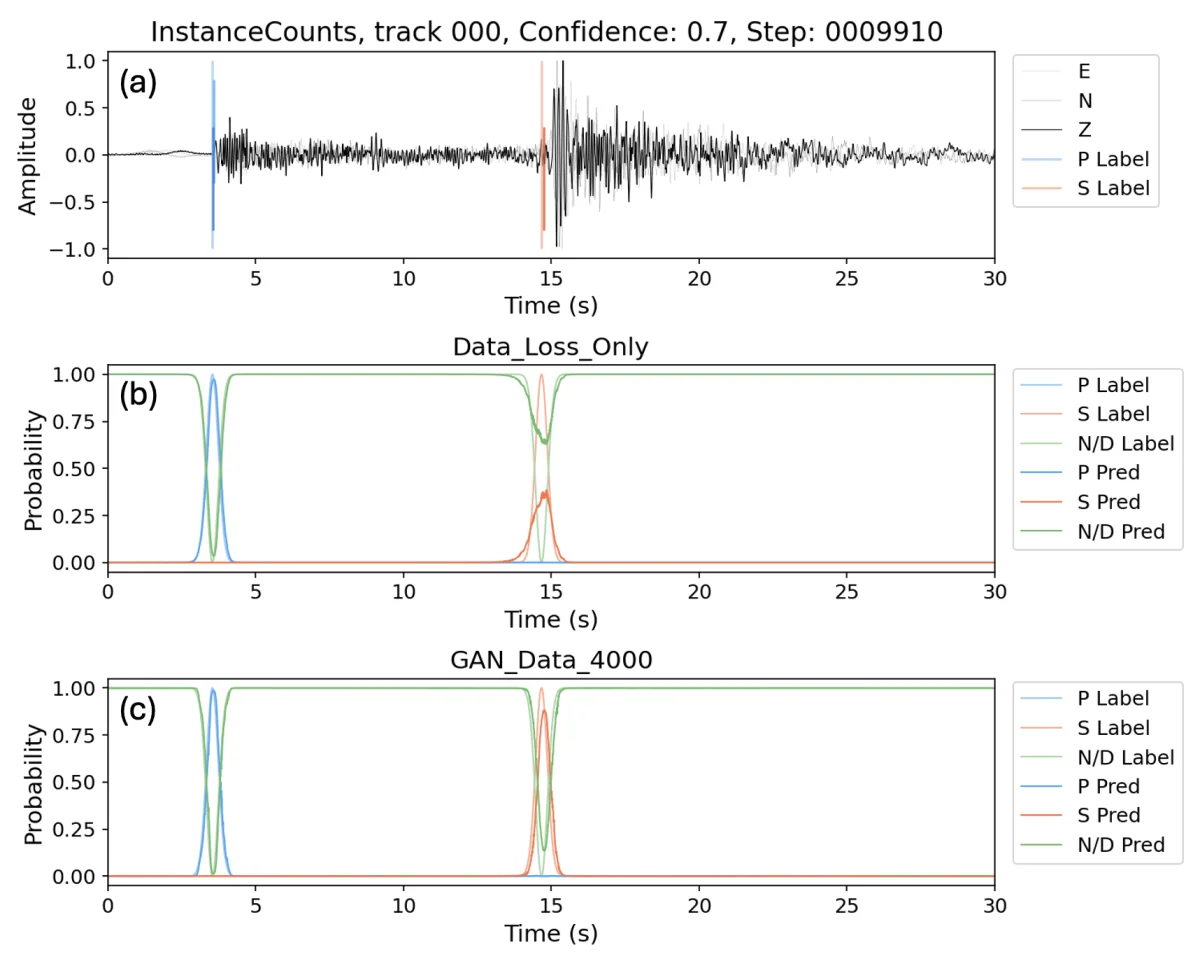
這項設計補上了原本缺少的訊號。模型不能只將每一格的數值調整正確,還必須使整體形狀合理, 否則便會被鑑別器識破。
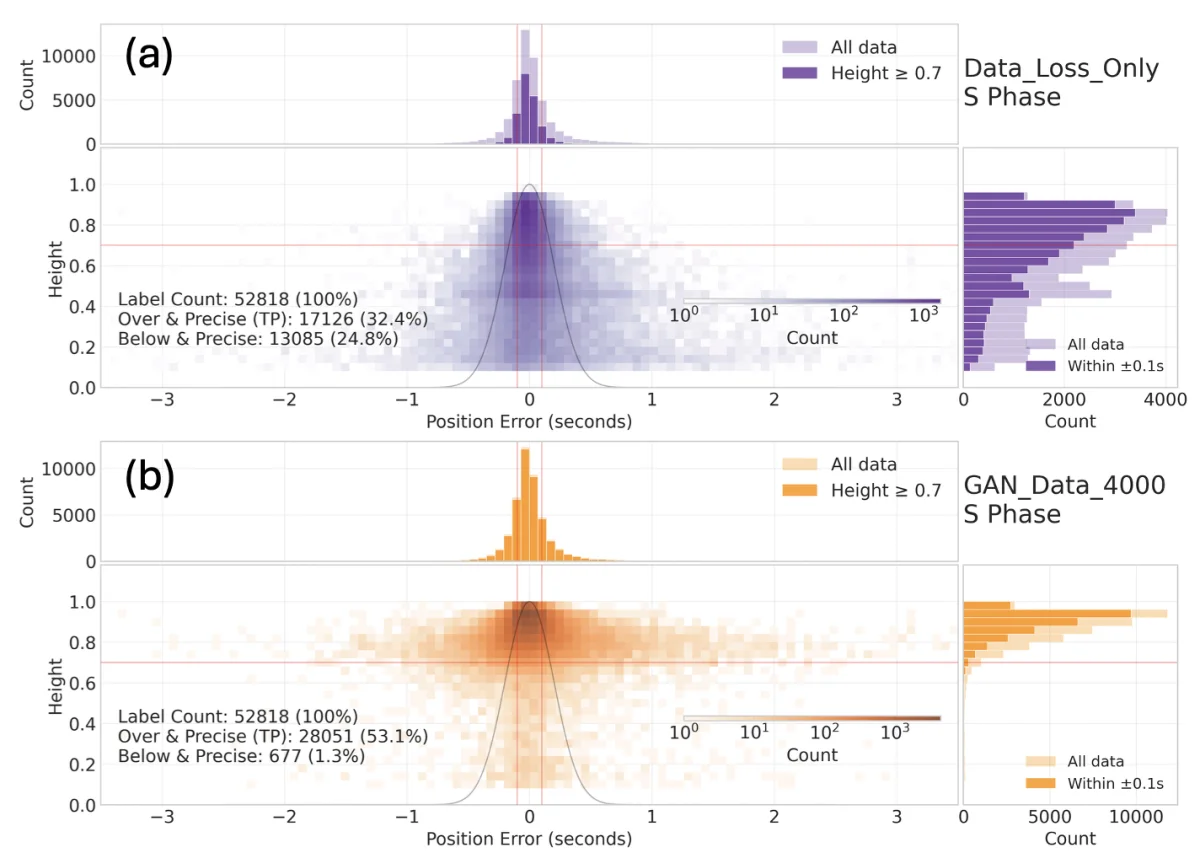
這項研究在 64% 之外的意義
64% 是相當亮眼的數字,但這篇論文更值得注意的地方在於方法。
論文將一個原本被視為工程問題的現象,拆解為可以理解、預測與分析的對象, 清楚說明預測為何停滯、停滯於何處,以及如何解除,整個流程因此從反覆試誤轉變為有原則的分析。
這套診斷方式不僅適用於地震,凡是需要從訊號中標記時間點的任務都適用, 例如心電圖中的心跳、衛星訊號中的事件,以及語音中的音節邊界。 只要標準答案是一個具有形狀的訊號,傳統的逐點評分都可能導致相同的問題。
論文最後提出一個觀點:理解損失函數本身的形狀,與理解模型架構同等重要。 研究者經常討論應採用哪種網路、增加多少層或使用哪種函數, 卻較少檢視模型所優化的目標本身是否設計得當。若評分標準本身有誤,即使採用更強大的模型,也無法解決這類問題。
參考文獻
Huang, C.-M., Chang, L.-H., Chang, I.-H., Lee, A.-S., & Kuo-Chen, H. (2025). Recovering Sub-threshold S-wave Arrivals in Deep Learning Phase Pickers via Shape-Aware Loss. arXiv preprint, arXiv:2511.06731.
arxiv.org/abs/2511.06731
ResearchGate
程式碼:github.com/SeisBlue/BlueDisc
附錄:訓練過程動畫
本文第一張圖的動畫版,可觀察 S 波預測如何隨訓練步數推進,逐漸被壓至偵測門檻以下。